大家好,我是程序员晚枫。
想做视频,不少人的第一反应是数字人,我之前也专门写过一篇:
用 WorkBuddy 积分免费生成数字人:「晚枫数字人 Skill」发布新版本
但聊下来会发现,数字人这条路对大多数人还是太贵:克隆音色、生成画面都按量付费,第一次试一条就得先掏 12 块;走积分那条虽然不花钱,却出不了自己的声音,成片也差点意思。
所以这次,我想找一条几乎不花钱的路。
前阵子我想做一条自我介绍的短视频。打开几个剪辑软件绕了一圈,越用越烦:模板是别人的,节奏是别人的,成品一看就是"套模板"。
于是我换了个思路:不剪视频,让 AI 把视频直接"写"出来。
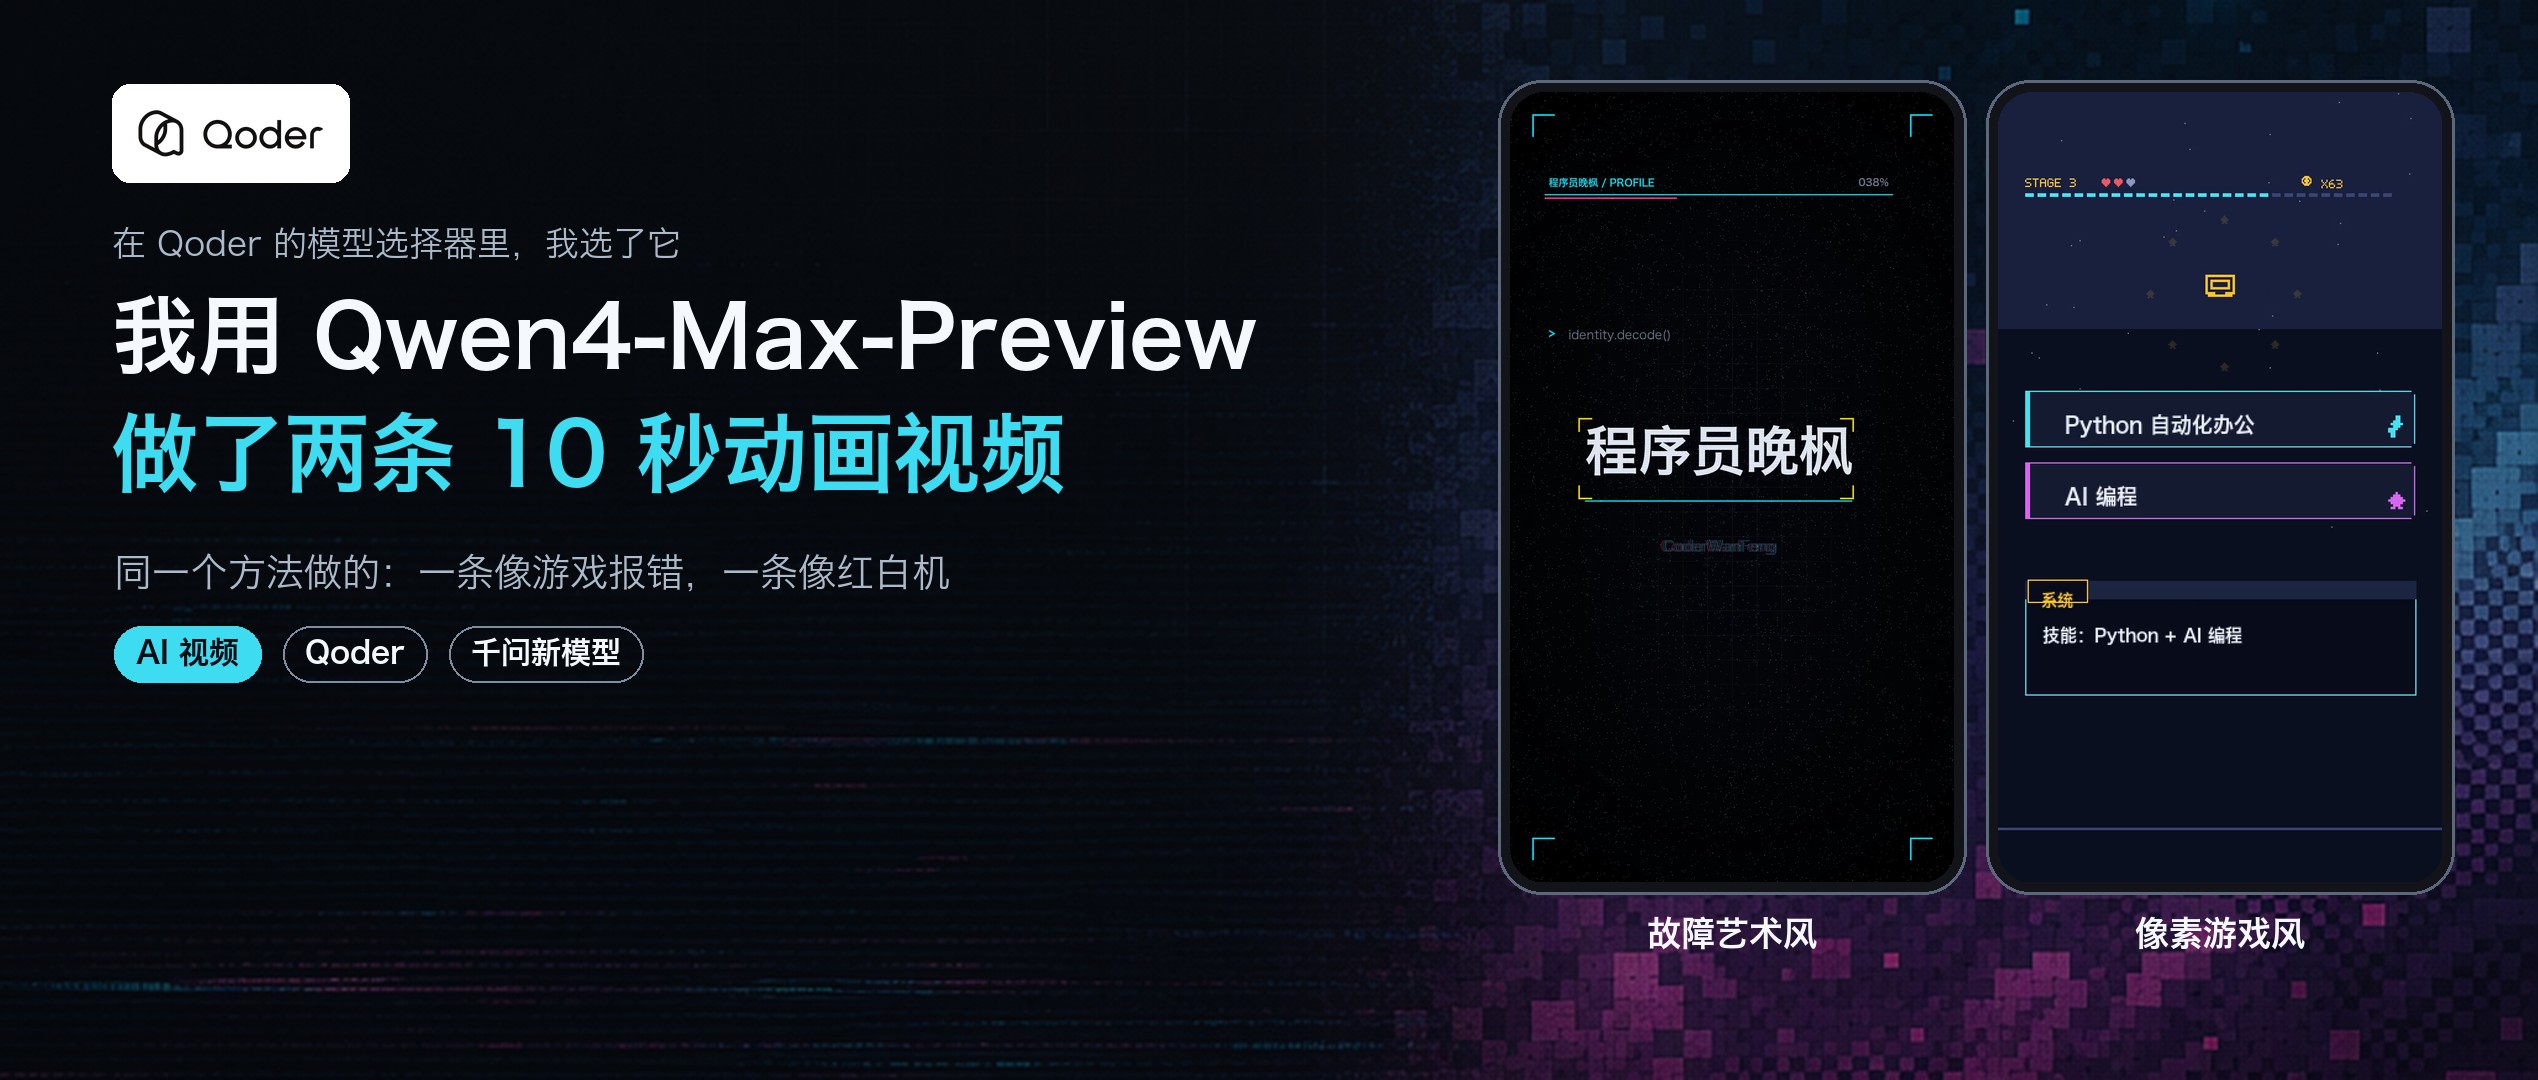
我在 Qoder 的模型选择器里选了 Qwen4-Max-Preview,把工作目录和一份我自己开源的 Skill 丢给它,只提了三个要求:介绍"程序员晚枫"这个人、控制在 10 秒、要两种风格。
后面它自己建目录、自己写渲染脚本、自己出检查图、自己改 bug。两条片子做完,我这边只看了两次画面、说了一句"内容全挤在上半屏"。
这次真正省下来的不是剪辑时间,而是"把想法讲清楚"的那部分工作量。
我全程只干三件事:提要求、看画面、挑毛病
先把流程说清楚,因为后面所有结论都建立在这上面。
以前想做这种视频,只有两条路:花钱找人剪,或者自己下个软件学三天,最后剪出一条 15 秒的、和模板一模一样的"原创"。
我用的 Skill 叫 ai-free-video,开源在 GitHub 上。它把"做一条宣传视频"拆成四步:先核对事实素材,再选视觉风格,然后做一条无声样片,最后收反馈。
我把这三句话的要求丢给模型之后,它做了四件事:
- 自己读完 Skill 的说明,建好两个风格的工作目录
- 自己写了两份 Python 渲染脚本,一份画故障艺术,一份画像素游戏
- 自己把关键帧拼成一张检查图发我,让我一眼能判断好坏
- 自己渲染出成片:1080×1920 竖屏、一秒 30 帧、整整 300 帧、没有音轨
值得说的是,这两条片子是两套完全不同的视觉语言。
故障艺术那一版,画面里的汉字是从一堆乱码"解码"成正常字的,配色是青红错位,还带扫描线和信号强度条。
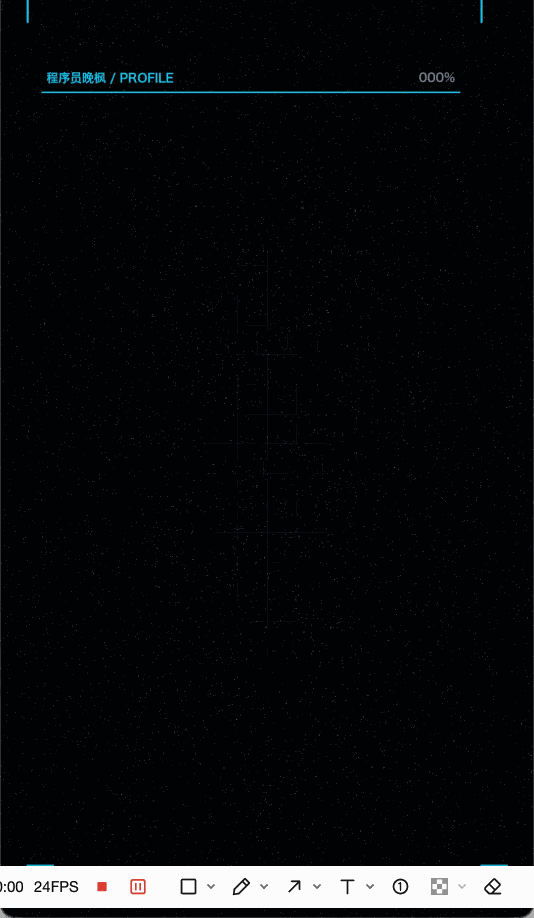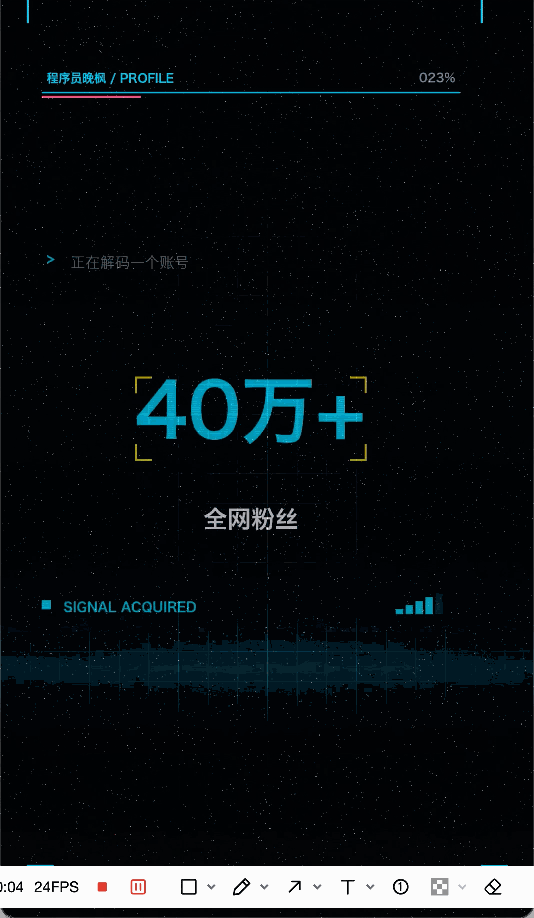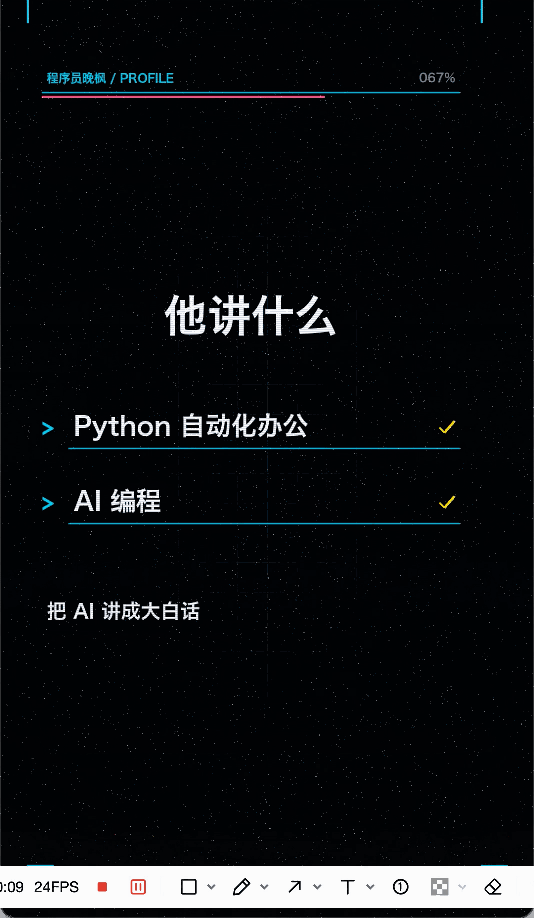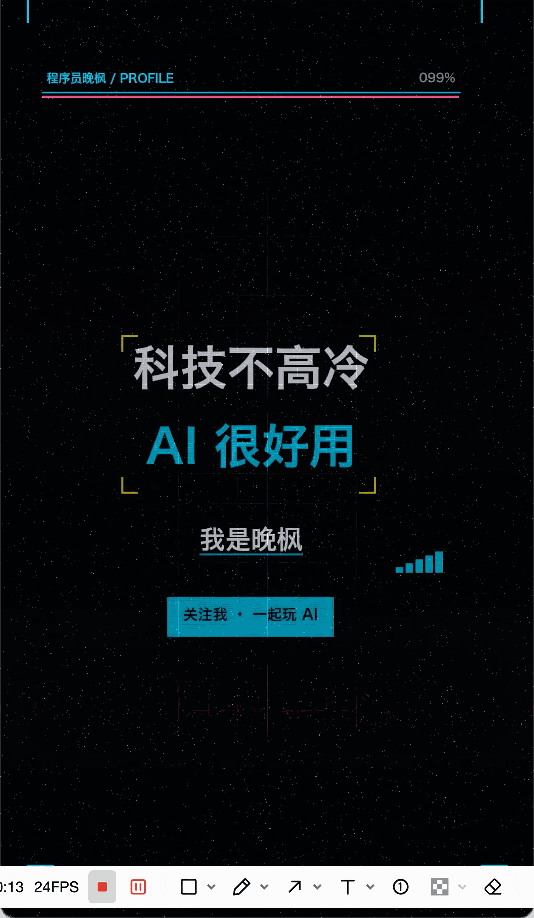
故障艺术版 10 秒无声样片,由 Qoder + ai-free-video Skill 生成
像素游戏那一版更极端:它先在 360×640 的低分辨率画布上画,再整体放大 3 倍。所以连中文字都带方块锯齿,是真正的红白机质感,而不是贴了一层像素滤镜。
这个做法我没有指定,是它自己决定的。
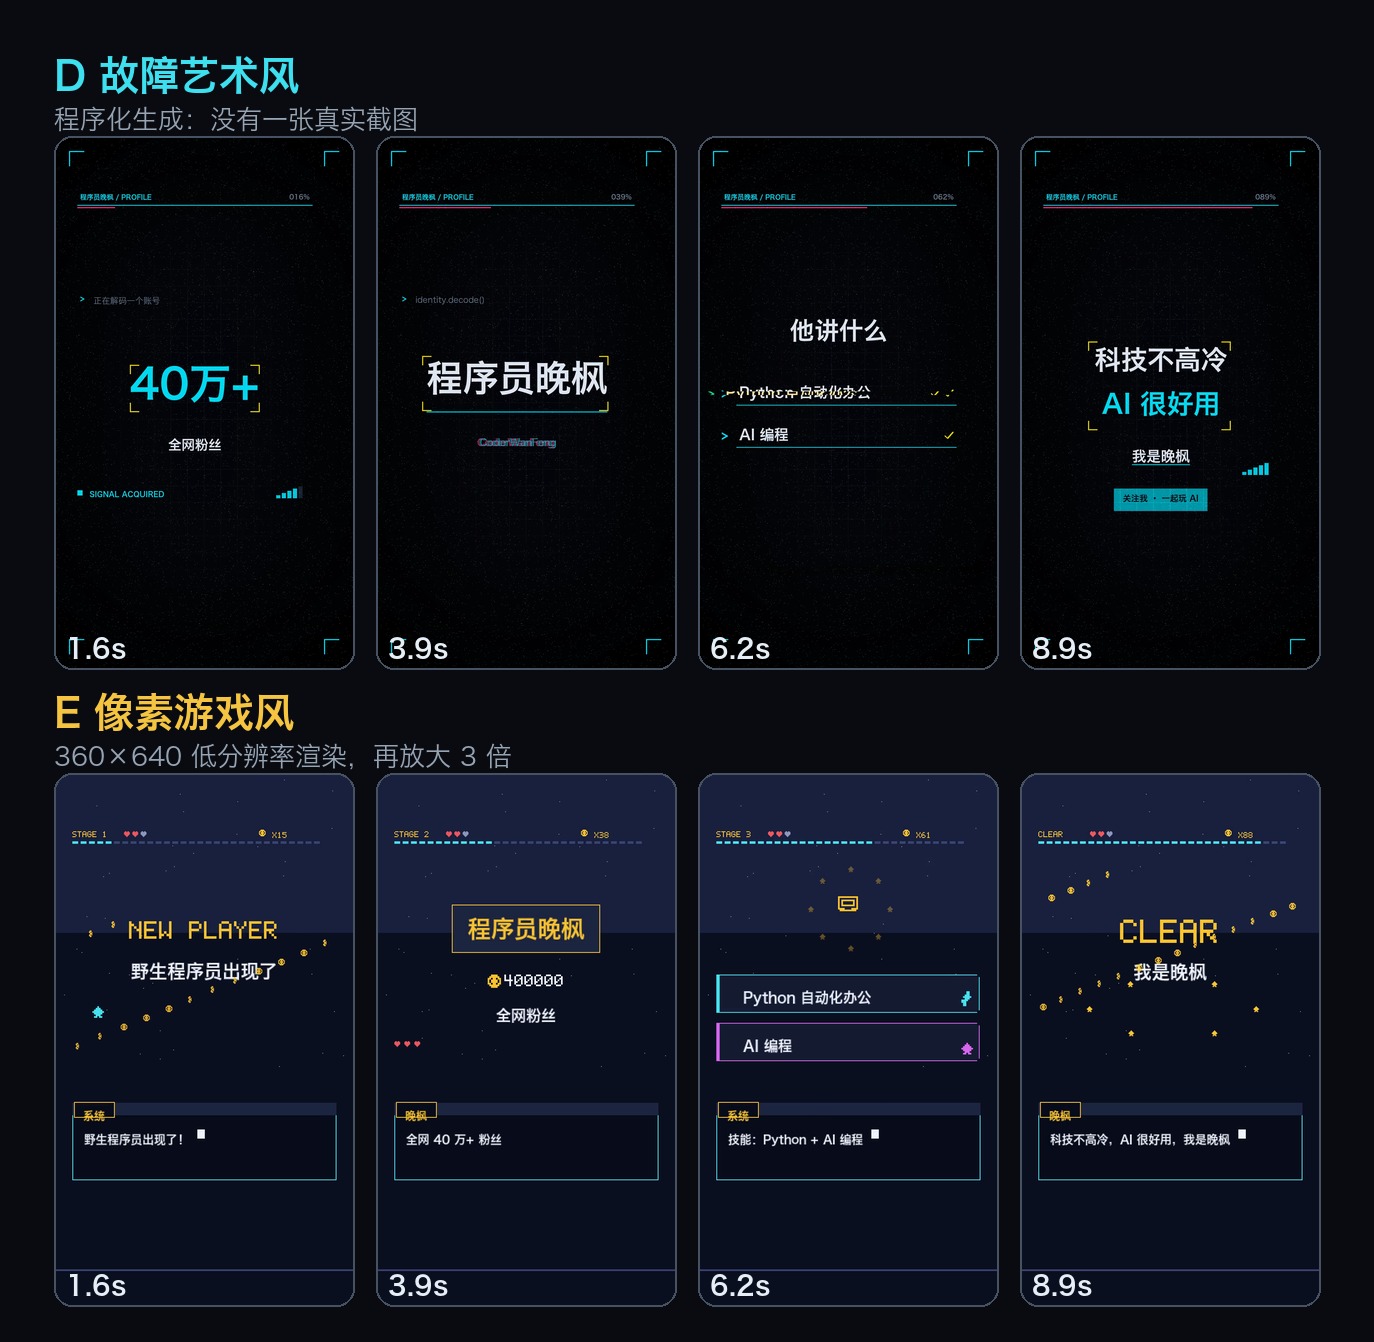
图片来源:本人使用 Qoder + ai-free-video Skill 生成的样片关键帧
让我意外的不是它会写代码,是它自己抓出两个 bug
这是这次体验里最值得讲的一段。
Skill 里有一条硬规则:画面里的文字不能互相重叠,也不能压到平台的界面区域——顶部 10%、右侧 15%、底部 22% 会被标题、点赞栏、评论框盖住,字放那里等于没放。
这条规则光写在文档里是没用的。AI 画着画着就忘了。
所以 Skill 里带了一个"重叠守卫":每渲染一帧,就把这一帧所有文字框拿出来算一遍,看有没有相交、有没有越界,最后写一份检测报告。
像素游戏那一版,第一遍跑出来两条红色告警:
- 大字
CLEAR顶部越界,压进了安全区 - 底部对话框里的正文和角色名牌重叠了 4%
有意思的是,这两处我肉眼基本看不出来。画面看着是"正常"的,只是坐标算出来是错的。
它排查出来的原因很典型:像素版为了省事,把所有画面整体往下挪了一段距离,但文字登记进守卫的时候,用的还是挪之前的坐标。
说白了就是——检查用的是一套坐标系,画面用的是另一套。 两边各说各话,检查等于没检查。
这类问题特别容易被误解成"AI 不会写代码"。恰恰相反,代码是能跑的,画面是好看的,只有验收标准被绕过去了。
它的修法是:干脆取消整体下移,把所有坐标改成屏幕绝对坐标,再把对话框里的正文往下挪,让它和名牌彻底分开。重跑一遍,报告全绿。
AI 编程真正的价值,不在于它能写多少代码,而在于它能把你那句模糊的"感觉不太对",变成一条可以反复重算的规则。
这一点我想展开讲,因为很多人用 AI 干活就卡在这。
你跟 AI 说"排版好看一点",它改完问你"现在好看了吗",你说"还是不对",来回十轮,两个人都很累。
原因很简单:好看不是一个能执行的东西。 模型每一轮都在重新猜你的口味,猜不到就重画一遍。
但如果这个要求能被写成一段检查代码——文字框不能相交、不能越界、报告必须全绿——那它就不是在猜,而是在算。算一次不对就改到对为止,改完还能再算一遍,确认没改坏别的地方。
这就是把审美变成工程。 我做视频时真正在做的也不是描述画面,而是提前定好"什么算做错了"。
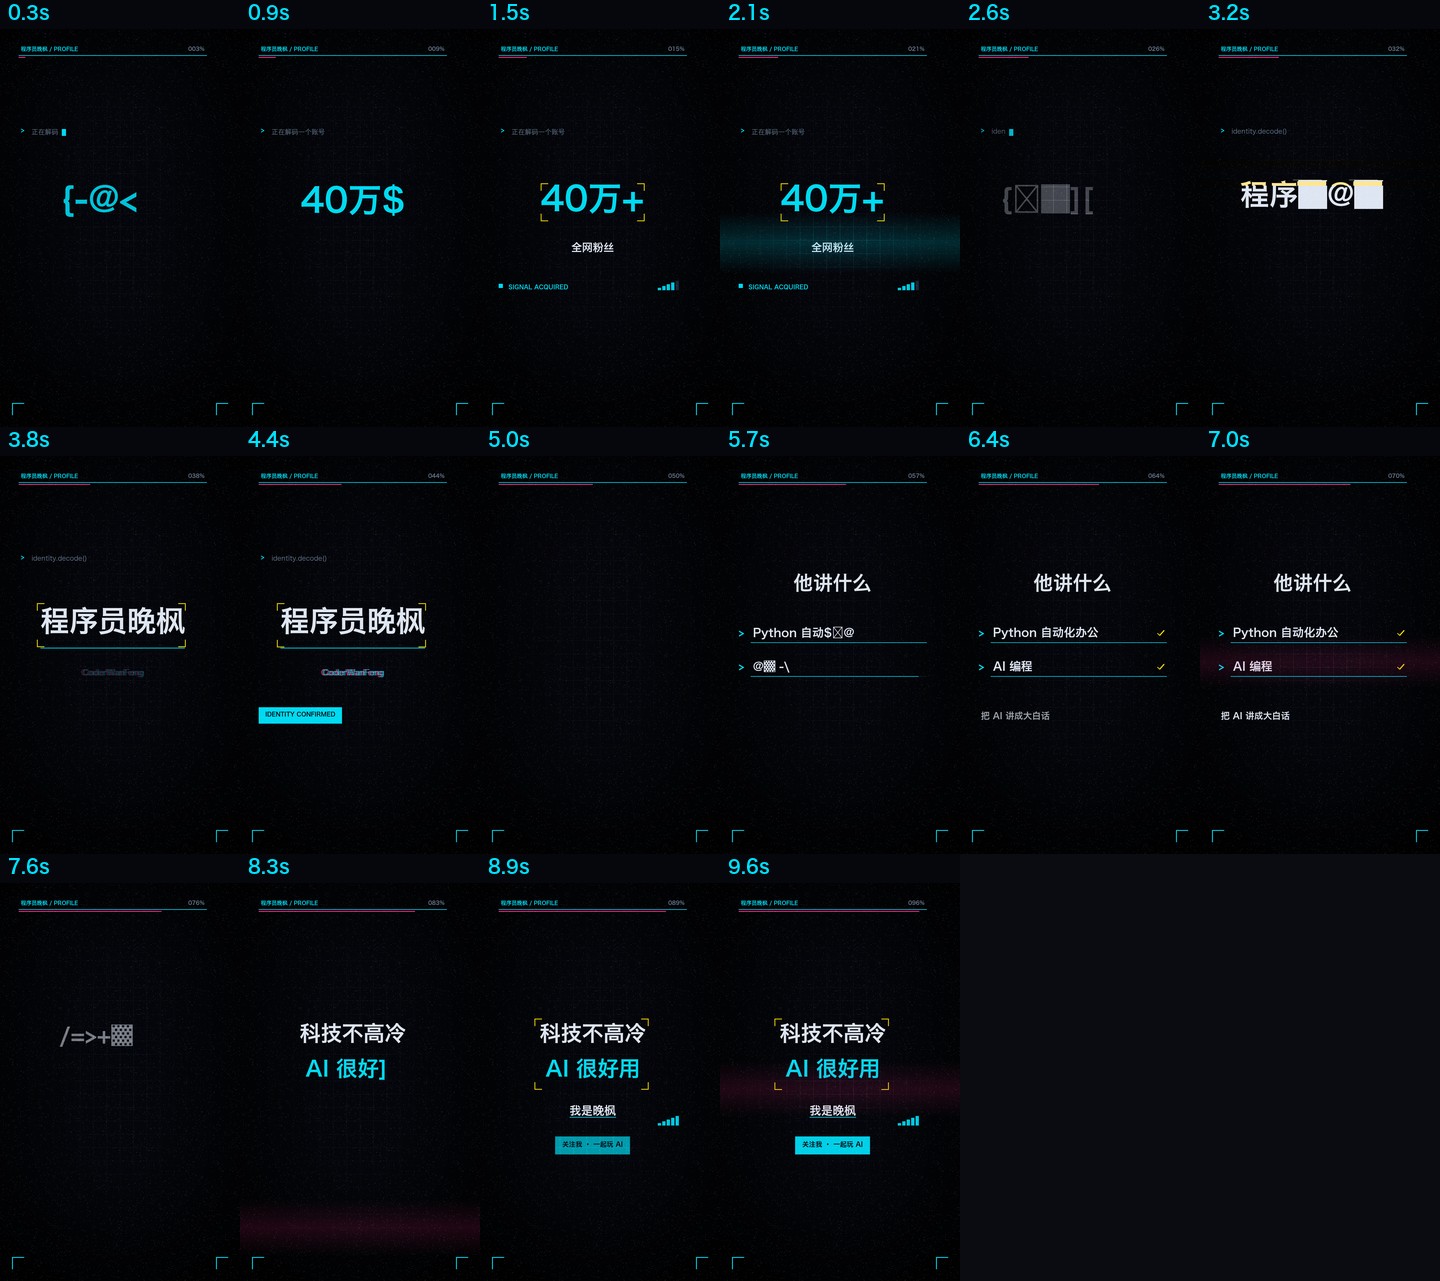
图片来源:Skill 自动生成的逐帧检查图,每一格都是成片里的真实一帧
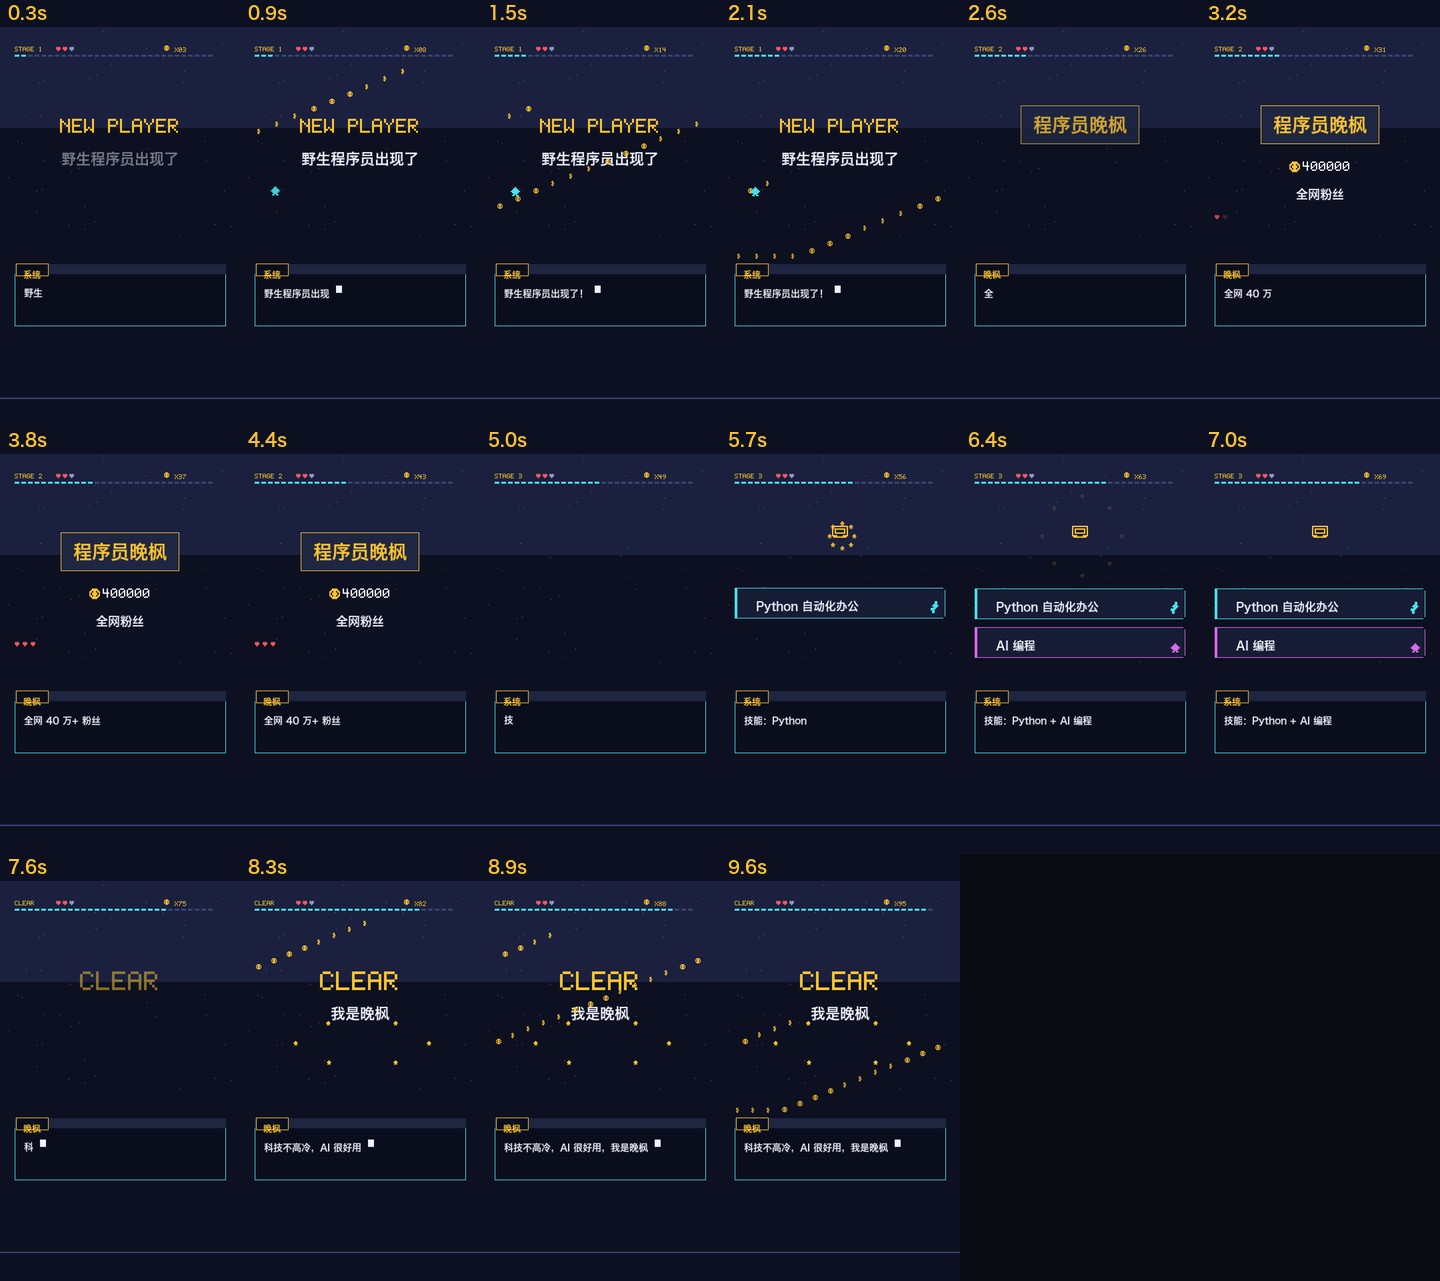
图片来源:Skill 自动生成的逐帧检查图,可以看到金币雨、宝箱、对话框逐帧变化
模型选择器那一排名字,到底该怎么选
有群友问我:凭什么选 Qwen4-Max-Preview?
先纠正一个我自己搞混过的点。
Qoder 的模型选择器里并没有一个叫"Qwen4 Pro"的模型,带 Pro 的是 DeepSeek-V4-Pro。千问这一列现在挂着三个,官方简介和倍率是这样的:
| 模型 | 官方简介 | Credit 倍率 |
|---|---|---|
| Qwen4-Max-Preview | Qwen 最新基座模型,世界感知更立体,复杂编程、专业办公与软件操作全面进阶 | 0.5× |
| Qwen3.8-Max | Qwen 基座模型,2.4T 参数,软件工程、办公与深度推理 | 0.5× |
| Qwen3.8-Flash | 开源权重多模态模型,能力、延迟与成本之间平衡 | 0.1× |
表里的倍率是官方给的综合预估值,实际消耗会受参数设置影响,以界面显示为准。
那这次为什么是 Qwen4-Max-Preview?因为做视频这件事看着简单,其实同时踩中三个难点。
第一,文件不小。 两份渲染脚本一份 675 行、一份 686 行,底下还压着一个 782 行的工具库。模型得记住这些接口长什么样,不能改着改着把自己依赖的函数名改了。
第二,要多轮自我修正。 它不是一次写对的。画面位置不对、坐标系混用、报告变红,每一轮都要在上一轮的基础上改,而不是推倒重写。
第三,它得遵守不是我定的规矩。 Skill 里写了一堆"不许":不许文字重叠、不许把截图缩得太小、不许加音轨。模型要是在这里自由发挥,整个流程就废了。
至于"世界感知更立体"这句官方描述,在我的场景里能感知到的是:它对画面的空间关系确实比较敏感。让它把内容整体下移,它知道下移之后安全区的边界要跟着重算,而不是把画面挪完就交差。
说白了,这类任务的瓶颈从来不是"会不会画",而是能不能在几十次修改里一直记得你要的是什么。
成本上,0.5× 的倍率跑两条 10 秒样片,我没心疼。但如果你的任务只是改文案、换个配色这种轻活,0.1× 的 Flash 完全够用。
贵的那一档不是更好,只是更适合重活。
两条片子做完,我最大的感受有点反常识。
我以为自己缺的是一个剪辑软件,其实缺的是一套"能验收"的流程。工具可以帮你把画面拼起来,但拼得好不好看,最后还是得有人说了算。
把"什么算错"提前写成规则,剩下的交给模型反复算——这个思路不只适用于做视频。写文档、做 PPT、改代码,其实都是同一件事。
如果你也试过让 AI "做得好看一点",结果来回改十几轮还是不满意,你最先想把它变成一条硬规则的是哪件事? 评论区说说你的场景,我挑几个下期实测。
科技不高冷,AI很好用。
我是晚枫,关注我,带你一起玩AI!
参考链接
- Qoder 模型选择器官方文档:https://docs.qoder.com/zh/user-guide/chat/model-tier-selector
- Qoder 官网:https://qoder.com/
- ai-free-video Skill 开源地址:https://github.com/CoderWanFeng/wanfeng-skills/tree/main/skills/ai-free-video
资料说明:本文的两条样片由本人在 Qoder 中选择 Qwen4-Max-Preview 生成,画面均为程序化绘制,未使用他人素材;两条成片为无声 MP4,存放在本地工作目录。模型名称与 Credit 倍率以 Qoder 官方文档当时页面为准。
相关阅读
- 千问大模型免费用了!Qoder 里 0 倍率,2 款模型白用
- 不要低估了 Kimi K3 生成视频的能力,10分钟做一条视频,成本不到1块钱
- 我用豆包工作,3 句话做了条自我介绍视频(附完整教程)
- 我做了个「开源搭子」skill:零基础也能秒推 GitHub,国内自动切镜像

 微信进群