🎬 成片视频:待补充视频链接:https://待补充视频链接
大家好,我是程序员晚枫。
截止到上个月,我对 AI 剪视频、AI 数字人,印象就俩字:生硬。
数字人走路像木偶,AI 剪的片子动效一多就露怯。我当时的结论是:好看,但没用。
这个月我不这么觉得了。
第一次改观是数字人给我的:点我看最新的「数字人视频」
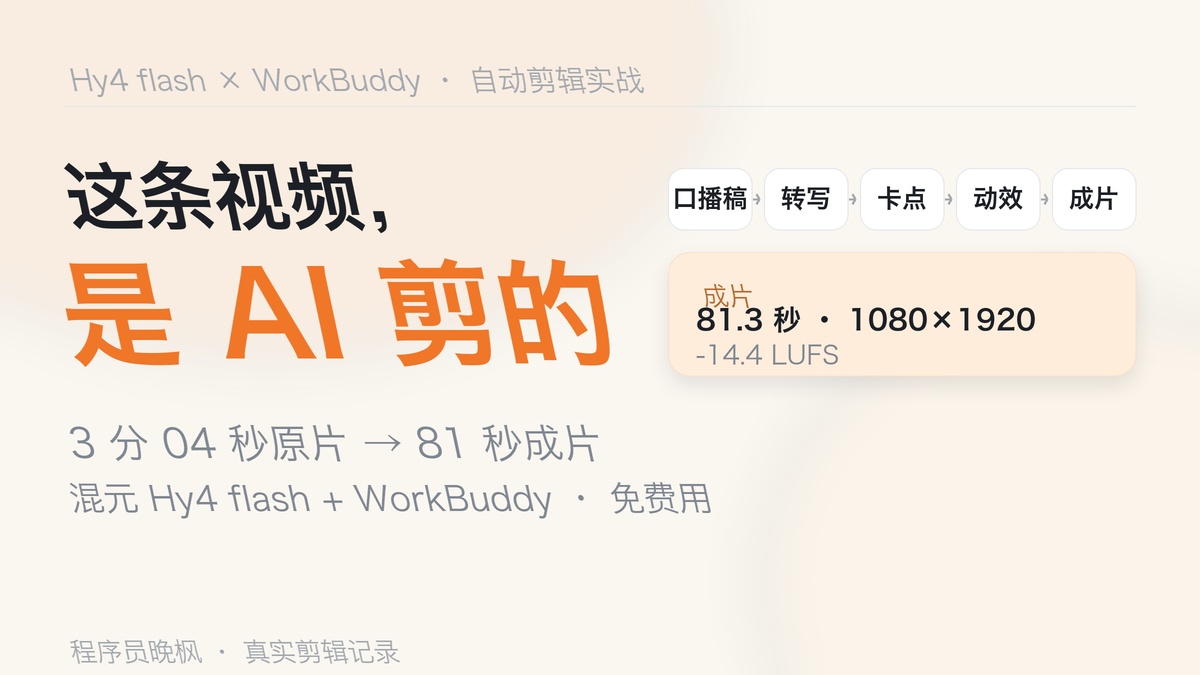
第二次改观是今天的 AI 剪辑,直接用效果说话!大家先看一下上面这条视频:3 分 04 秒的原片,剪成 81 秒,全程 0 积分——剪辑这件事,是 AI 干的。
这下不能再因为不会剪辑,就不录视频了吧?
继续说说这条视频是怎么剪出来的。
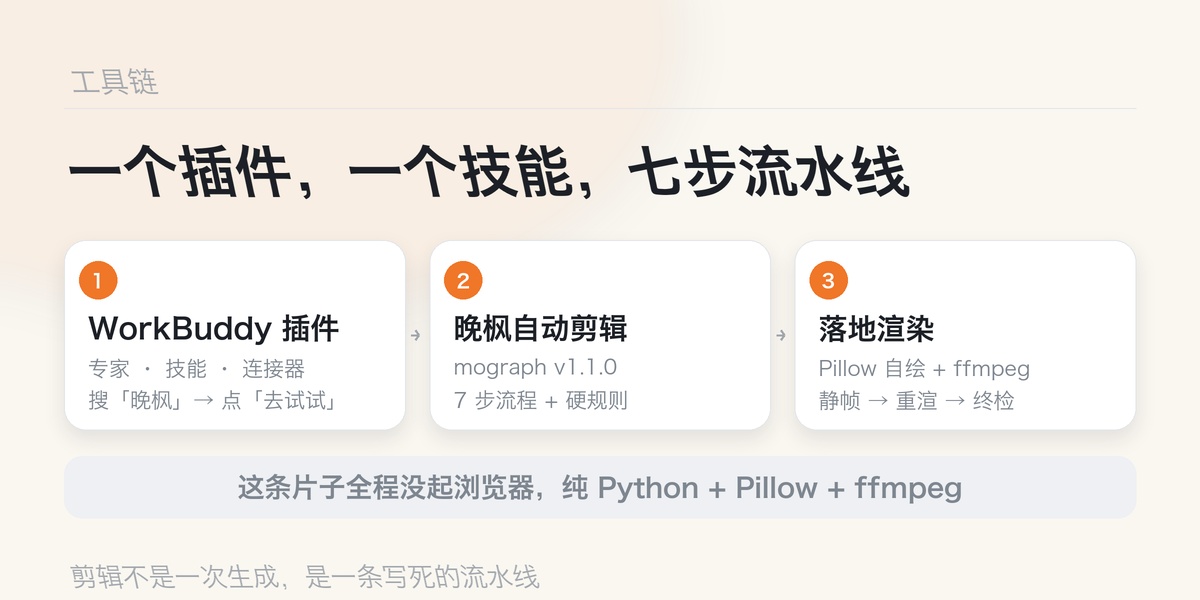
图:从 WorkBuddy 插件到成片的三段链路 · 晚枫自制插图
一、我用了什么插件、什么技能
我下面以腾讯出品的 WorkBuddy 为例,给大家介绍我是怎么自动剪辑视频的。
如果你是其他AI工具,也可以直接去用,因为技能就是一个文件夹——SKILL.md 加参考文档加脚本,Claude Code、Cursor 这类能加载 Skill 的工具,把下面这个链接放进去就能用。
GitHub 源码:晚枫自动剪辑 mograph:https://github.com/CoderWanFeng/wanfeng-skills/tree/main/skills/mograph
在 WorkBuddy 里,我到底用了什么
还没下载 WorkBuddy 的朋友,免费下载链接:WorkBuddy 官网邀请页:https://www.workbuddy.cn/events/invite?inviteCode=b1m7bevc9r7ma52y
WorkBuddy 里找东西,认准三栏:专家、技能、连接器。 我这次用的是中间的「技能」。
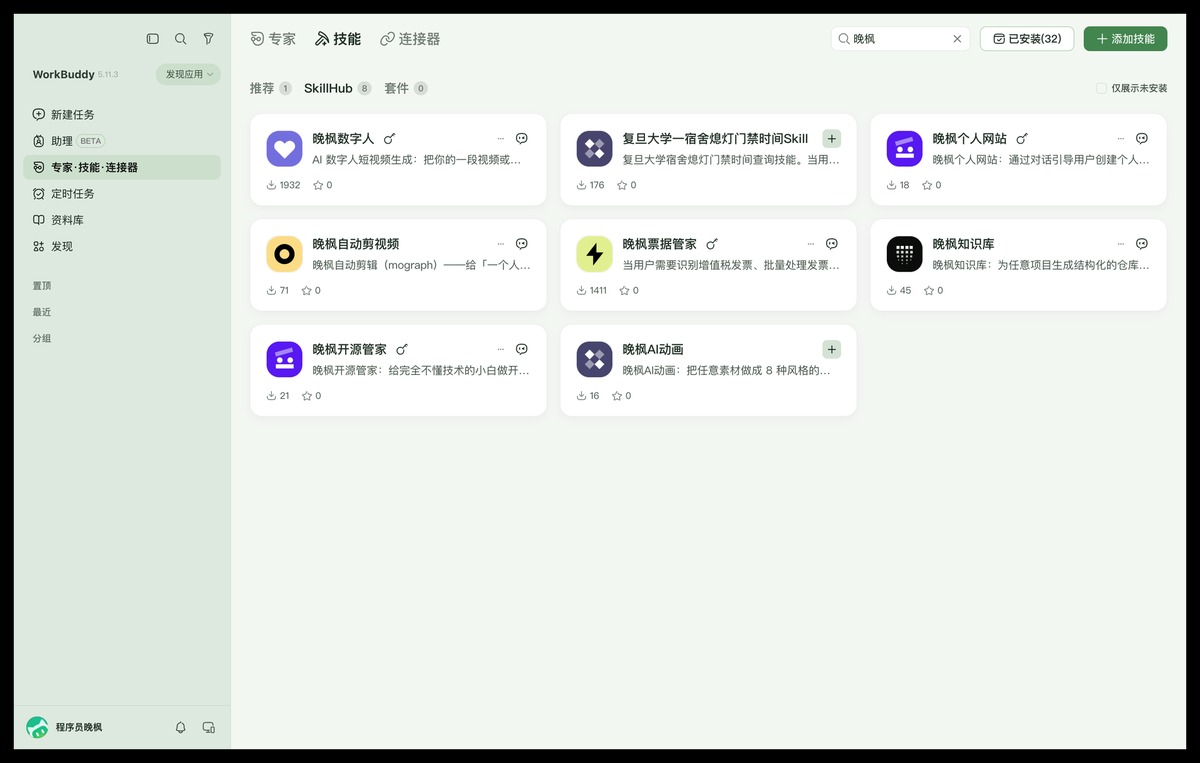
图:WorkBuddy 技能广场搜索「晚枫」· 来源:WorkBuddy 界面截图
搜「晚枫」,出来一排我做的技能。剪视频这个叫**「晚枫自动剪辑」**,代码名 mograph,下载七十多。
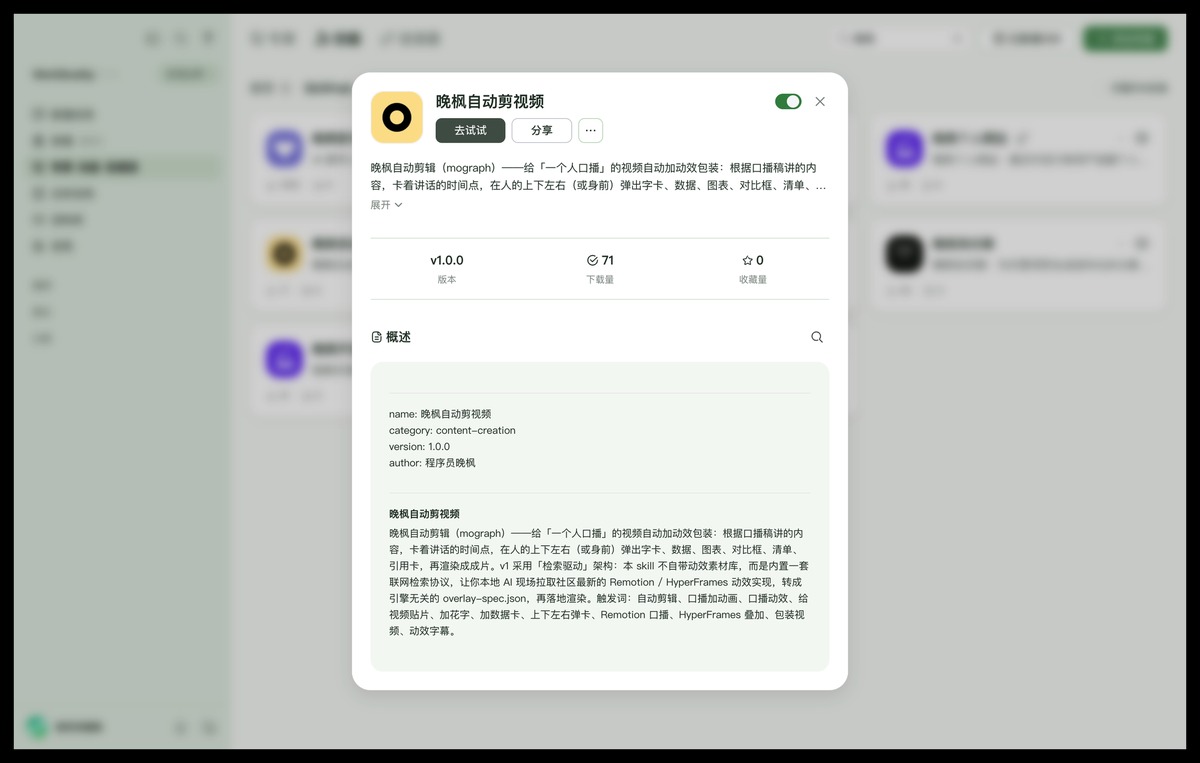
图:晚枫自动剪辑技能详情页 · 来源:WorkBuddy 界面截图
详情页右上角三个按钮:去试试、分享、更多。点「去试试」,它会直接把技能拉进对话框。
(页面显示 v1.0.0,我本地仓库已迭代到 v1.1.0——技能广场更新总是慢一拍。)
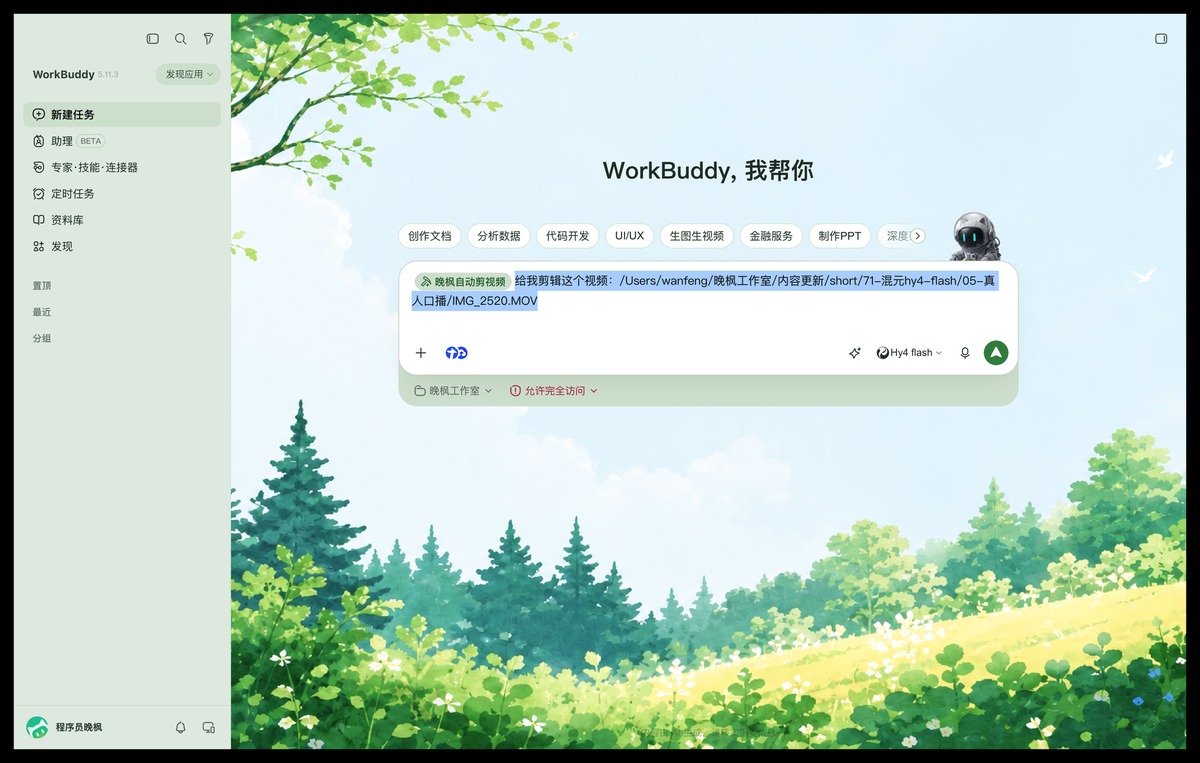
图:在 WorkBuddy 里下达剪辑指令 · 来源:WorkBuddy 界面截图
然后就一句话,把视频丢给它:「给我剪辑这个视频:+ 文件路径」。
对普通人来说,这一步才是真正的门槛。以前剪一条 3 分钟口播,光导字幕、调样式就够折腾一晚上——现在就是丢个文件进对话框。
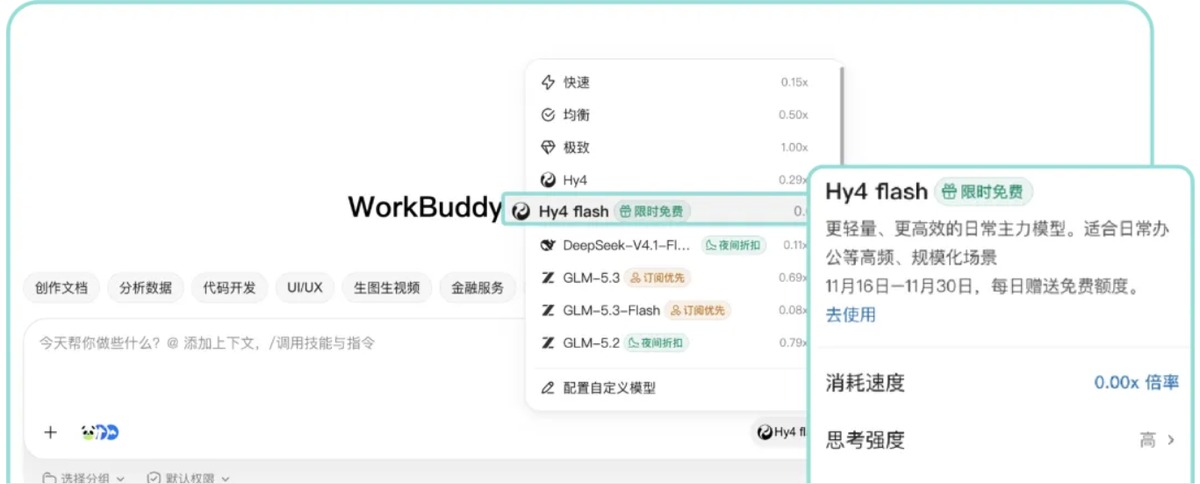
图:模型列表里选择 Hy4 flash · 来源:WorkBuddy 界面截图
右下角选模型,选 Hy4 flash。这一步很关键,决定这次剪视频花不花积分。
在 WorkBuddy 里,用 Hy4 flash 跑剪辑,倍率 0.00x、技能费 ¥0,所以这次是 0 积分。
这里得澄清一点:WorkBuddy 里 Hy4 flash 当前限时免费,所以这次不花积分。
技能的每一步,在干什么
这个技能是我写的,叫 mograph,开源在 GitHub。它最有意思的不是剪得多好,是结构。
常见做法是把一堆动效素材打包进工具里,用的人越多素材越旧。我这个技能反着来——它不自带任何动效素材,只沉淀三样不会过期的东西:位置语义、时间轴契约、检索协议。 找最新实现这步,交给运行时联网去干。
整条流水线上,每一环调用的技能也不一样:
| 环节 | 调用的技能 | 干什么 |
|---|---|---|
| 写口播稿 | knowledge-short-video | 把想说的话拆成一句一句,标好每句作用 |
| 找动效实现 | mograph 的检索协议 | 联网搜社区最新实现,筛掉许可不清的,记下来源 |
| 加动效包装 | mograph(晚枫专用路径) | 算时间轴、画卡片、排版、渲染、拼成片 |
| 只想要字幕 | embedded-captions | 不要动效、只要字幕时用这个 |
| 做封面 | cover-hero / hyperframes | 和正文复用同一套设计风格 |
mograph 自己内部,是一条写死的七步流水线:
| 步骤 | 这一步在做什么 |
|---|---|
| 第 0 步 | 一次问清 5 个开关:风格路径、画幅、动效密度、渲染引擎、卡片要不要压在人前面 |
| 第 0.5 步 | 分叉:走通用流程,还是走「晚枫专用」——我这条片子走的是后者 |
| 第 1 步 | 出骨架:把口播稿切成场景,给出时间区间和建议版式,离线秒出 |
| 第 2 步 | 补肌肉:联网找社区最新动效实现,按"能跑 / 许可 / 匹配 / 迁移成本"四维打分筛 |
| 第 3 步 | 填动画:把"想要什么动画"写成具体参数——进出场、时长、缓动、元素顺序 |
| 第 4 步 | 落位校验:人脸安全区里不放卡,同屏超上限的直接弃卡,不硬塞 |
| 第 5 步 | 选渲染器落地:网页版方案(Remotion / HyperFrames)优先,只有 ffmpeg 也能兜底 |
| 第 6 步 | 自检三闸:覆盖率不低于 40%、抽 6 帧看有没有压脸、任意连续 5 秒内要有画面变化 |
| 第 7 步 | 交付:时间轴文件 + 检索记录 + 成片,换渲染器不用重做分镜 |
技能文档里写死的那些要求
文档里有一节「硬规则」,7 条,每条后面都写了违反的后果。挑几条用得上的:
| 规则 | 说的是什么 | 违反了会怎样 |
|---|---|---|
| R1 | 估算出来的时间必须标注,交付前必须试听对齐 | 卡点和讲话错位,整片废 |
| R2 | 卡片上的数字只能来自口播稿,不许自己编 | 编造数据,发出去就是事故 |
| R3 | 不做人像抠图,卡片默认在人后面 | 抠图质量差,直接毁掉真人出镜 |
| R4 | 检索失败必须明说"本次未联网",不许假装引用了社区实现 | 许可和来源都不可追溯 |
| R5 | 引入外部代码前先确认许可 | 商单成片有法律风险 |
| R6 | 不调用任何付费接口 | 试错成本失控 |
| R7 | 验证用的截图看完即删 | 工程目录变脏 |
晚枫专用那条路还额外挂了 11 条自己的规矩:
- 静帧不干净,绝不重渲全片——全片渲染 6 分钟起,版式问题在静帧上改只要几秒;
- 渲染完先验时长,再谈内容——后台任务被杀,会留下"看着正常、其实打不开"的废片;
- 终检必须逐张读图,不能只看抽了多少帧。
还有一节「已知限制」,列了 9 条。第一条就是:v1 不做剪辑。
所以这条片子剪掉的 63 秒废话,是我照着它扫出来的静音表,一刀一刀定的。它负责把时间轴算准、把卡片画好、把片子拼出来;判断留在我这边。
想自己试的话,这技能是开源的。在 WorkBuddy 里点「去试试」就能用;换个工具,就按上面说的把仓库里的技能文件夹加载进去。
源码里最值得翻的是技能文档和它下面的参考目录——一份是七步流程加硬规则,一份是晚枫专用路径的全部版式参数。
也可以直接在 SkillHub 上一键装:
SkillHub 发布页:晚枫自动剪视频:https://skillhub.cn/skills/user_bf8c5b73/wanfeng-mograph
在 SkillHub 里复制这句话发给它就行:
1 | 请根据 https://skillhub.cn/install/skillhub.md,安装 @user_bf8c5b73/wanfeng-mograph。 |
二、为什么是混元 Hy4 flash
先说结论:剪视频这件事,模型从来不是瓶颈,能跑完的流程才是。
剪一条 3 分钟口播要连续跑几十轮:算时间轴、读截图、改版式、写文案、核字幕。十几轮下来,消耗是聊天的好几倍。
所以挑模型我只有三个标准:快、便宜、上下文够长。
Hy4 flash 的官方数字刚好卡在这条线上:
| 指标 | 数值 |
|---|---|
| 总参数 | 224B(其中 64B 是 Engram 参数) |
| 激活参数 | 12B |
| 上下文 | 1M,支持多模态 |
| 每百万 token 输入 | 0.5 元 |
| 每百万 token 输出 | 2 元 |
| 命中缓存 | 0.02 元 |
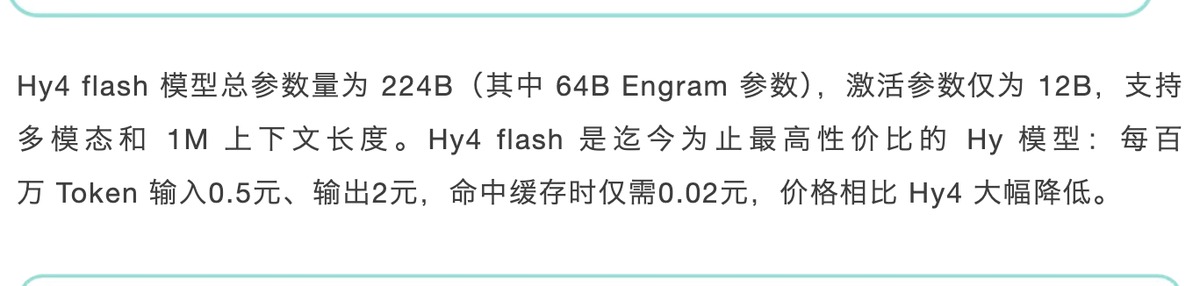
图:Hy4 flash 官方参数与价格 · 数据口径:腾讯混元官方发布稿
这里有个知识点:为什么总参数 224B,激活却只有 12B?
这是稀疏激活的思路——模型参数像一座图书馆,224B 是藏书总量,但回答一个问题只需翻几本书。激活 12B 就够,省下的不是效果,是每个 token 的算力和电费。
那 64B 的 Engram 参数,官方没展开讲内部机制,我也不敢瞎猜。但价格表给了个暗示:命中缓存时每百万 token 只要 0.02 元,是全价的四十分之一——说明模型确实有东西可复用。
官方盲测里,1M 上下文任务 Hy4 flash 平均 6.7 分钟完成,单次任务成本在 ¥0.26 这个量级。
我的体感更直接:从"我想试试"到"真能用",就差在能不能跑完那十几轮。 跑不完的工具,再聪明也是摆设。
最后把账算清一次:WorkBuddy 里 0 积分是平台侧当前限时免费,腾讯云 API 按量付费是官方按 token 计费。两套账,别混。
三、AI 没有替代谁
以前我们很爱说"AI 要替代谁"——替代客服、替代翻译、替代初级程序员。
这条片子剪完,我的想法变了:它替代的不是人,是那些一直被跳过的活儿。
那 44 段静音,我以前剪片是听出来的。拖时间轴,一遍遍听,看到卡壳就手动切。人耳会被疲劳打败,剪到第八遍,我已经不确定那段留没留——那不叫剪辑,那叫抽奖。
这一次,44 段空隙是扫出来的,起止时间精确到毫秒。我只需要做一件事:决定要不要切它。
那 15 个动效场景的版式、每张卡写什么字、哪个数字放大——这些是我的活儿。观众要看的是我说的话,不是好看的框。
所以这条片子真正发生的事是:它把我原本会偷懒跳过的笨活儿接过去了。
我以前总把"剪视频"分两半:操作归机器,审美和判断归人。后来发现这分法本身就错了——操作从来就不属于人,人属于"想清楚要什么"。
AI 干的那部分,是普通人做不到、也不愿意做的:它不会累,不会烦,不会因为今天状态差就把一段静音漏掉。
AI 数字人已经够真了,那我还能做什么
这个疑问是朋友看完成片后问我的:AI 数字人都已经这么离谱了(我写过一篇,用 WorkBuddy 积分免费生成数字人:「晚枫数字人 Skill」发布新版本),直接让 AI 派个人出来讲不就行了?你干嘛还自己录?
我想了想,答案是:镜头是为了可信,不是为了生产。
观众点进来,不是来看一张会动的脸,是想听"晚枫踩过什么坑、做了什么判断"。数字人能把台词一字不差地说完,但那些坑,它没踩过。
数字人是演员,稿子还是我写的;脸是我的脸,节奏是它剪的。
所以下次再听到"AI 要取代谁了",我现在的答案是:先别急着表态,把这件事拆开看——它替你干的那部分,是你自己本来就懒得干、或者干不下来的吗?
如果是,那你不是被替代了,你只是终于有人搭把手了。
如果你也用 AI 剪过视频,最花时间的那一步是哪个?评论区说说,我挑几个具体的说。
科技不高冷,AI很好用。
我是晚枫,关注我,带你一起玩AI!
参考链接
- 腾讯混元 Hy4 官方研究页:https://hunyuan.tencent.com/research/hy4
- 腾讯混元官网:https://hunyuan.tencent.com/
- 腾讯云 · 混元大模型 API 文档:https://cloud.tencent.com/document/product/1729
- 晚枫自动剪视频 SkillHub 发布页:https://skillhub.cn/skills/user_bf8c5b73/wanfeng-mograph
- 晚枫技能仓库 GitHub:https://github.com/CoderWanFeng/wanfeng-skills
- WorkBuddy 官网:https://www.workbuddy.cn/
相关阅读

 微信进群