大家好,我是程序员晚枫(Wayne Liu)。
「我这张卡跑 H3,一条 5 秒视频到底要等多久?」——这是后台问得最多的一句。
今天就把话说透:显存决定能不能跑,也决定你要等多久,但它决定不了画质上限。
先把数据来源讲清楚,免得误导:下面的耗时、显存、分辨率数字,来自 MiniMax 官方开源说明、ComfyUI 官方教程,以及社区公开的量化版实测汇总。我按 RTX 4090(24GB)这一档整理成表,不同量化格式、驱动版本、提示词长度都会有出入,这是可复现的公开口径,不是我逐台机器掐表跑出来的。
👉 点击这里下载 LibTV 桌面端: https://libtv.cgref.cn/s/9omkl4jn4d
一、5 秒视频要等多久,先看你在哪一档
先给一张对照表。这是社区用量化版跑出来的量级,方便你对号入座:
| 显卡 | 显存 | 一条 5 秒视频大概耗时 | 能稳定出的画质 |
|---|---|---|---|
| RTX 3060 / 4060 | 8–12GB | 约 5–10 分钟 | 480p 为主,768p 要压时长 |
| RTX 4070 Ti / 4080 | 12–16GB | 约 1–2 分钟 | 720p–768p |
| RTX 4090 | 24GB | 约 1–2 分钟(长片段约 10 分钟) | 768p 标准参数 |
| RTX 5090 | 32GB | 10 秒片段约 175 秒 | 768p 高时长更从容 |
再放两个参照系,你就知道「快」是有代价的:官方口径里,4 张 H100(80GB)跑一条约 13 秒;而 2 张 RTX 5090 生成 5 秒约 9 分钟。
同一个模型,从 13 秒到 10 分钟,差了几十倍。
差的不是模型聪明不聪明,是算力和显存带宽。
所以「MiniMax H3 生成速度」这个问题,从来不该问「H3 快不快」,该问「你这张卡跑 H3 快不快」。
我见过有人拿办公本跑,等了十分钟去泡了杯茶,回来进度条还在第一帧。
嗯,那杯茶倒是不亏。
二、显存是硬门槛,不是「差一点也能凑合」
这里得讲透一个原理,不然你会一直纠结「我 8GB 是不是也能跑」。
官方权重是 BF16 精度,主网络 33B 参数、文本编码器 32B,合计约 130GB。这个体积单张消费级显卡根本放不下。
那为什么 12GB 也能跑?靠三件事:
- 量化:把权重从 16 位压到 4 位、8 位,相当于把一本精装书缩印成口袋本,体积能小到几分之一
- 动态卸载:显存放不下的部分临时挪到内存,要用再搬回来,像书桌太小就先把不常用的书放回书架
- 步数压缩:把 20 步的精修降到 4–8 步的速写,画面糙一点,但快得多
于是就有了这张显存档位表:
| 显存 | 可行配置 | 实际体验 |
|---|---|---|
| 6–8GB | 4 位量化 + 卸载,480p、短时长 | 能出片,但接近「抽卡」 |
| 12GB | 4 位量化,768p 低时长或 480p 满时长 | 入门门槛,RTX 3060 这一档 |
| 16GB | 4 位量化,768p 标准参数 | 比较舒服,4070 Ti Super 级别 |
| 24GB | 4 位 / FP8,768p 高时长 | 最稳的一档,也就是 4090 |
「MiniMax H3 显存要求」的一句话答案:12GB 起步,24GB 舒服,8GB 以下别硬撑。
还有个规划上的坑:显存占用 = 权重体积 + 生成时的临时缓存,而缓存随时长、分辨率往上走。所以同一张卡,8 秒能跑不代表 15 秒也能跑。稳妥做法是先用 8 秒验证,再逐步加时长。
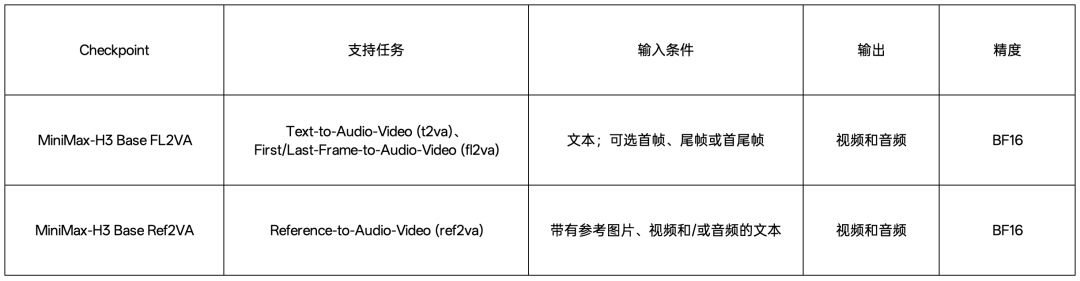
图片来源:MiniMax H3 官方开源说明
另外官方放的是两个检查点:FL2VA 管文生视频、首尾帧;Ref2VA 管多图、视频、音频参考,最多 9 张图 + 3 段视频 + 3 段音频。参考素材越多,进模型的序列越长,显存吃得越狠——这也是「配置够」还失败的一个隐藏原因。
👉 点击这里下载 LibTV 桌面端: https://libtv.cgref.cn/s/9omkl4jn4d
三、画质:768p 是本地的天花板,不是显卡的锅
很多人问我:「我 4090 都上了,怎么还出不了 2K?」
因为这不是显卡问题,是开源范围问题。
MiniMax 开源的是 H3-Base,输出短边默认 768 像素、24 帧、最长 15 秒、32kHz 立体声,支持 11 种语言对白。而把它拉到原生 2K 的 H3-Regenerate-2K,还有负责把复杂指令翻译好的 H3-Context-IR,这两个都还在官方托管服务里,只给接口,没给权重。
所以本地能调的画质旋钮,其实是这三个:
| 能调的 | 怎么调 | 代价 |
|---|---|---|
| 步数 | 20 步精修 ↔ 4–8 步速写 | 快了容易丢细节 |
| 分辨率 | 864×480 抽卡 → 1344×768 出最终版 | 高分辨率更慢、更吃显存 |
| 抽卡次数 | 同一提示词多跑几遍挑最好的 | 时间成本 |
「MiniMax H3 本地有声视频」这件事是真做到了——画面和声音在同一个模型里一起生成,不是后期配音。这一点比画质数字更值得说。
反过来,「把分辨率硬拉到 2K」这条路目前在本地不存在。别在设置里翻了,翻不到的。
顺带说一句授权:权重受 MiniMax H3 Community License 约束,有适用地域和营收门槛,商用界面还要求显著标出「MiniMax H3」。所以别把「本地免费」直接理解成「随便商用」。
最后说句实在的。
显卡决定的是「等多久」,开源范围决定的是「能到哪」。把这两件事分清楚,你就不会为了一个本地根本不存在的 2K 按钮,去怪自己那张 4090 不够贵。
选对档位,比堆配置有用得多。
💬 来评论区聊聊
你手上是哪张卡、跑一条 5 秒要多久?评论区报个型号和耗时,咱们攒一张真实的配置对照表。
参考链接
- MiniMax H3 官方开源说明(输出规格与三模块): https://www.minimax.io/news/minimax-h3-open-source
- MiniMax H3 官方模型仓库: https://huggingface.co/MiniMaxAI/MiniMax-H3
- ComfyUI 官方 H3 教程: https://docs.comfy.org/tutorials/video/minimax/minimax-h3
- MiniMax H3 社区许可说明: https://huggingface.co/MiniMaxAI/MiniMax-H3/blob/main/LICENSE
相关阅读
💬 再聊一句
如果你也想按自己显卡的档位,把 H3 本地这一段跑顺,不妨点下面的链接,试试 LibTV 桌面端。
一个人,也能把一条片子从提示词做到成片。
👉 点击这里下载 LibTV 桌面端: https://libtv.cgref.cn/s/9omkl4jn4d
科技不高冷,AI很好用。
我是晚枫(Wayne Liu),关注我,带你一起玩AI!

 微信进群