一句话总结:我把自己账号那条剪口播的路,从「我记得该怎么剪」写成了「AI 照着做」。10 步,一条手机原录进去,成片加封面出来。
大家好,我是程序员晚枫。
我前面发过一篇「晚枫自动剪辑」,那是免费版:给任何口播做通用包装,讲话到哪句、卡片弹到哪句,卡片样式跟着你给的参考片走。
发出去之后一直有个绕不开的问题:它剪出来的不是我账号那种感觉。
这个说法我不觉得是批评。通用包装本来就该跟着别人的风格走。真正的问题在另一边——我自己的风格,一直是装在我脑子里的,说不清、教不会、别人也带不走。
这次我把它写下来了。名字叫晚枫自动剪视频 Pro。
先给最硬的一个数字。
我有一条真实发布出去的口播,手机一口气录完的原片 184.14 秒。它先剪成 84.36 秒的干净底片,最后传上去的成片是 81.30 秒,竖屏 1080×1920、30 帧,里面有 15 个画面。
中间那 100 多秒去哪了?这是这篇文章真正想讲清楚的事。
剪掉废话之前,先问一句
原片 184.14 秒里,92.50 秒是静音,占了 50.2%。
一口气录完的口播就是这样:想词、重来、半截句、「嗯」、说错了从头再来。这些不是内容,是录音的副产品。观众不会觉得「这个人是在想词」,他们只会觉得这条片子怎么这么长。
所以第一件事是把它们删掉。但这里有个我咬死的规矩:
不能自作主张剪掉你说的话。
这个 skill 的第 0 步不是删,是问。它会先给你一段说明,问你允不允许删重录废稿和长停顿;你说「可以」,它才动手;你说「不要」,原片一个字不动,它只做后面的画面包装。
剪完还会给你一份完整保留的口播稿——不是刀口清单,是「最后留下哪些话」的全文,你可以逐条对着看。允许删减也不等于允许重排,重排要另外同意。
这条规矩来自一次实证。它删得准不准,不能靠「感觉剪得挺干净」。
拿那条 71 号原片做过一遍:机器标出的 7 处语义刀口,100% 命中人工标注,零误删。也就是人说该剪的地方它全找到了,它自己多下刀的地方是 0。
顺手还有个数字:机器只把 184.14 秒收到 114.32 秒,比人工的 84.36 秒保守得多。这是刻意的——工具宁可少删,也不能把一句完整的话从中间劈开。激进的活留给人。
一条流水线 10 步,一图看完
上面那一步只是开头。整条路是这样:

图由 skill 自带脚本生成,图上每个 Step 编号都能对上文档正文。
三段,十个环节,说白了是这么回事:
① 准备:先问你能不能剪废话 → 定好这期用什么样式 → 按讲的内容找配图,标好出处。
② 制作:一段话配一个画面,一条条自己定 → 先导出几张静态图看一眼,改干净再往下 → 一张一张画出来拼成整条片子(约 6 分钟)→ 每个画面挑一张图,一张一张看有没有问题。
③ 交付:音量量一遍、对齐平台要求 → 写清这期用了什么样式、下期直接抄 → 在固定底图上换字换 logo,人像完全不动。
为什么不套模板,要一张一张画
这一步也是它跟免费版分岔的地方。
免费版走的是通用路线:找一个现成的动效工程,把文字填进去,参数一改,出片。快,但有个天花板——里面有什么,你才能有什么。 它给了三种卡片,你的第四种想法就出不来;想改一处圆角、一处留白,得去翻它的配置文件。你改的是别人的工程,不是画面。
这条 Pro 线换了个方向:每一帧都是现场画出来的。 工具是 Python 加 Pillow,画矩形、画圆、写字、算坐标,再用 ffmpeg 把 2439 帧(81.3 秒 × 30 帧)拼成一条片子。全程只吃 CPU,不用装 Node、不用起浏览器、不用显卡、不调任何付费接口。
代价是慢,全片渲染 6 分钟起。所以它配了一条硬规矩:静态图没检查干净,不许重做整条片子。 改一处样式在静态图上只要几秒。
收益是画面里能出现任何东西:步骤条、圆形人头、琥珀色小标签、把截图框住的红框、一句口播配一张专门的图——只要稿子里说了,画面里就能有。样式不再是限制,而是跟着内容长的。
时间会被剪掉,画面时间必须跟着走
这条线里有一条纯粹技术性的规则,但讲透它,你就懂整条流水线在干什么。
剪掉静音以后,每句话的起点都会往前挪,而且越靠后的句子挪得越多。如果画面还按老时间排,就会出现:你嘴上在讲第二步,画面上还挂着第一步的截图。
修法不是「把画面往后挪一挪」,而是建一张映射表:原片时间 → 成片时间,所有画面时间都要过这张表换算一次。改语速也一样——这条线会把开头一段按 1.2 倍提速,音频动了,画面时间轴不动就错位。
这条线把这件事做成了可验证的:拿 ffmpeg 测出语音停顿点,跟映射表预测的时刻比对,误差小于 80 毫秒。有了这个数,验收就不再是「听着差不多对得上」,而是差了多少毫秒。
成片解剖表里那 15 个画面的时间,全是过完映射表之后的成片时间。
三个入口、两笔账、四条丑话
只有 Pro 有的一样东西:一致性
| 免费版 | Pro 版 | |
|---|---|---|
| 卡片排法 | 自动判断、自动放 | 一段话配一个画面,自己定 |
| 用什么做 | 现成动效工程 | 逐帧自己画,纯 CPU |
| 要装什么 | Node 或浏览器 | Python + ffmpeg |
| 整体感觉 | 跟你的参考片走 | 固定一套,每期看着一样 |
| 剪废话 | 有,先问你 | 有,规则带实测数据 |
| 开头提速 | 无 | 有 |
| 音量对齐 | 无 | 有 |
| 封面 | 无 | 有 |
| 交付说明 | 简版 | 八节 |
最后一行别当成附赠。每次交付都带一份交接文档,写清「这期改了什么」和「哪些不许改」——这条是给「下期接着做」准备的,不是给甲方看的。
拿到它有三个入口,但只有一个能买
这次跟以前不一样,我先把一句话说在前面:Pro 版源码不公开。
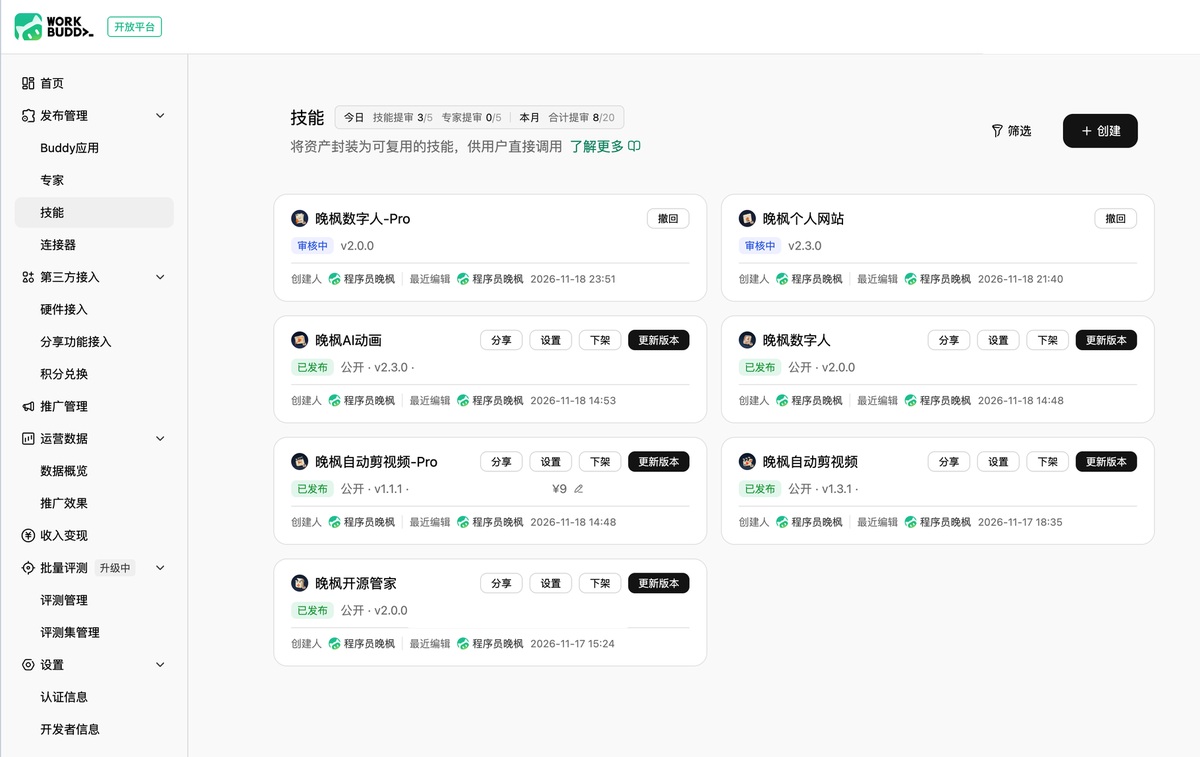
点开就是技能详情,价格、包含什么、授权期限都以这个页面当日显示为准。
先用免费的试试手感:晚枫自动剪视频(免费版)SkillHub 发布页:https://skillhub.cn/skills/user_bf8c5b73/wanfeng-mograph
想看开源部分:wanfeng-skills 仓库(免费版在这里,Pro 不在):https://github.com/CoderWanFeng/wanfeng-skills
为什么 Pro 不进仓库?因为卖的不是代码,是那套路子:固定样式参数、封面打法,以及 18 条规则、13 条踩坑清单背后的实测数据。这些一旦公开,付费就没有意义了。我在仓库的 .gitignore 里把它单独排除,发布脚本里也写进了跳过清单。
所以授权条款也简单:你买的是使用权,不是源码所有权。 用它做出来的视频、封面、文档,版权归你,可以商用、可以发布、可以再编辑;skill 本身的代码和规范不得转售或再分发。
装上之后说什么话
不用记命令,说人话就行:
「这条口播视频按我们自己的风格剪,走晚枫那条路」
「用 Pro 版把这条做成有版式的成片」
「做完顺便换张封面,把字改成『免费用 XX』」
「这条原片太啰嗦了,先帮我剪一下」
要是你只想用其中一件事,也可以单跑,不必做整条片子:只剪废话(只要 ffmpeg,不要图像库)、只做封面(换字换 logo,秒级出图)、只要画面清单(口播稿加字幕,纯标准库、离线秒出)。
封面那条我拿真实交付的成品对过一次:模板脚本产出的图,和当时交出去的图逐像素比对,最大差值 0。这不是「差不多」,是一模一样。
四条丑话,先说完再买
我觉得这四条比优点重要。
第一,它不帮你分镜。 画面清单脚本只给时间区间和建议样式,每一场的图和文案必须自己写。这是故意的:自动分镜只会吐出一堆平庸的通用卡。
第二,macOS 才顺。 字体绑死了 macOS 自带的冬青黑体(Hiragino Sans GB)。换到没这个字体的机器,要手工换字体、把静态图重新跑一遍。
第三,封面底图里的人是我。 换封面是「人像不动、只换字换 logo」。你要做成你自己的账号封面,得另配底图并重算一套对齐值,不是填两个字的事。
第四,配图得你自己有,或者它去找,但不保证找得到。 小众工具经常没有公开截图。找不到就退回纯文字动效卡——图跟口播对不上是事故,宁可少配几张。
真正值钱的不是那 6 分钟
回头看那个数字:184.14 秒的原片,剪到 81.30 秒,短了 100 秒。
但省下来的不是这 100 秒。原来我要在剪辑软件里点两三个小时的活——找哪句话讲完了、把卡片对齐到那一帧、音量拉一遍、封面重排一版——现在变成一句「按我们自己的风格剪」。
而它真正替代的,也不是我的两只手。
一个人做内容做到某个阶段,最贵的资产是「我记得该怎么剪」。 它不出货,只在每次开工时消耗你,还随时会跟着你一起消失。
为了让 AI 照我的路子做,我不得不把一些一直没想明白的地方想明白:为什么胶囊不能跟底色同亮度,为什么提速必须同时改两边,为什么封面人像是死的。我以为那些是审美,写下来才发现是规则。
如果你也在做口播,迟早会碰到同一个问题:你的做法,除了你,还有谁能执行?
先回答它,再决定要不要买。拿不准就先试免费版——那条线开源、不要钱,风格是我的还是你的,一试就知道。
用的时候有问题,文章下面留言,我都会回。
科技不高冷,AI很好用。
我是晚枫,关注我,带你一起玩AI!
参考链接
- 晚枫自动剪视频 Pro · WorkBuddy 技能页:https://www.workbuddy.cn/share/asset?shareCode=l6Db2M9PIgSq7zGj98JuOD&sig=UpntKZbYiI8mJ8uj
- 晚枫自动剪视频(免费版)SkillHub 发布页:https://skillhub.cn/skills/user_bf8c5b73/wanfeng-mograph
- SkillHub 安装说明:https://skillhub.cn/install/skillhub.md
- wanfeng-skills 开源仓库(免费版源码):https://github.com/CoderWanFeng/wanfeng-skills
- Pillow 官方文档(逐帧绘制用的图像库):https://pillow.readthedocs.io/
- ffmpeg 官方站点(拼接与音量处理):https://ffmpeg.org/
相关阅读

 微信进群