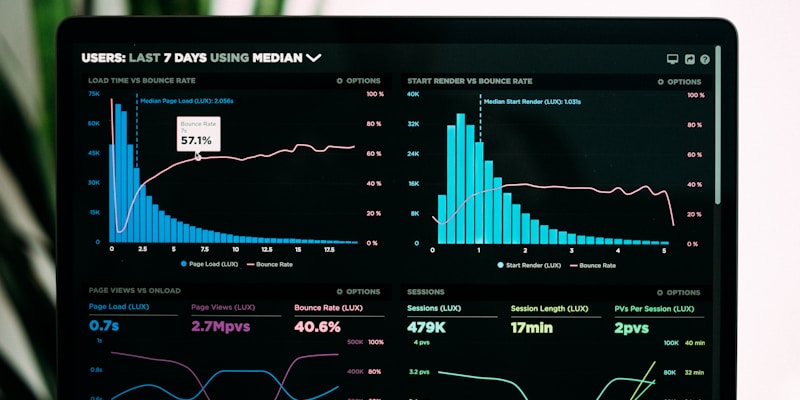
模块 6 · 可观测性与稳定性(第 11 周)
💡 一句话总结:上线不等于能用——出问题 5 分钟内定位、10 分钟内止血,这是 FDE 的稳定性基本功。
🎯 本模块三大特点
📚 系统:模块 6 在 12 周 Residency 中的定位是 生产守夜人——前面 9 周做开发,这周做"防意外"
🔧 实战:1 周内接 Prometheus + Grafana + 跑 1 次混沌演练
⚡ 不啰嗦:跳过监控原理,直接给可用的告警规则
📖 学习导航
📅 一周时间表
| 时间 | 任务 | 产出 |
|---|
| Day 1-2 | LLM 链路追踪 + Token Cost 看板 | 1 个 LangSmith 看板 |
| Day 3-4 | Prometheus + Grafana 三件套 | 1 个生产监控 |
| Day 5 | 混沌演练 + SLO 报告 | 1 份 SLO + 1 次演练记录 |
🚀 直接开始:3 个核心实战任务
任务 1:LLM 调用链路追踪
目标:让 1 次请求的所有环节可追溯(LLM 调用、Token、耗时、成本)
难度:⭐⭐
时间:1 天
LangSmith 接入(一行配置)
1
2
3
4
5
6
7
8
| import os
os.environ["LANGCHAIN_TRACING_V2"] = "true"
os.environ["LANGCHAIN_API_KEY"] = "lsv2_xxx"
os.environ["LANGCHAIN_PROJECT"] = "客户项目名"
from langchain_openai import ChatOpenAI
llm = ChatOpenAI(model="gpt-4o")
|
自定义 Metrics(用 prometheus_client)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
| from prometheus_client import Counter, Histogram, Gauge
import time
llm_requests_total = Counter(
"llm_requests_total",
"Total LLM requests",
["model", "status"]
)
llm_request_duration = Histogram(
"llm_request_duration_seconds",
"LLM request duration",
["model"],
buckets=[0.5, 1.0, 2.0, 3.0, 5.0, 10.0]
)
llm_tokens_total = Counter(
"llm_tokens_total",
"Total tokens used",
["model", "type"]
)
llm_cost_total = Counter(
"llm_cost_total_yuan",
"Total cost in CNY",
["model"]
)
llm_active_requests = Gauge(
"llm_active_requests",
"Active LLM requests"
)
def track_llm_call(model, func, *args, **kwargs):
llm_active_requests.inc()
start = time.time()
try:
response = func(*args, **kwargs)
duration = time.time() - start
llm_requests_total.labels(model=model, status="success").inc()
llm_request_duration.labels(model=model).observe(duration)
if hasattr(response, "usage"):
llm_tokens_total.labels(model=model, type="prompt").inc(response.usage.prompt_tokens)
llm_tokens_total.labels(model=model, type="completion").inc(response.usage.completion_tokens)
return response
except Exception as e:
llm_requests_total.labels(model=model, status="error").inc()
raise
finally:
llm_active_requests.dec()
|
任务 2:Prometheus + Grafana 三件套
目标:完整 Metrics / Logs / Trace 监控
难度:⭐⭐⭐
时间:2 天
Prometheus 配置
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
|
global:
scrape_interval: 15s
scrape_configs:
- job_name: 'ai-service'
static_configs:
- targets: ['ai-service:8000']
- job_name: 'node'
static_configs:
- targets: ['node-exporter:9100']
- job_name: 'postgres'
static_configs:
- targets: ['postgres-exporter:9187']
|
Grafana 看板(关键面板)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
| {
"dashboard": {
"title": "AI 系统生产监控",
"panels": [
{
"title": "QPS(每秒请求数)",
"type": "graph",
"targets": [{"expr": "rate(llm_requests_total[5m])"}]
},
{
"title": "P95 响应时长",
"type": "graph",
"targets": [{"expr": "histogram_quantile(0.95, rate(llm_request_duration_seconds_bucket[5m]))"}]
},
{
"title": "Token 用量 / 小时",
"type": "graph",
"targets": [{"expr": "sum by (model) (rate(llm_tokens_total[1h]))"}]
},
{
"title": "成本 / 小时",
"type": "graph",
"targets": [{"expr": "sum by (model) (rate(llm_cost_total_yuan[1h]))"}]
},
{
"title": "错误率",
"type": "graph",
"targets": [{"expr": "rate(llm_requests_total{status='error'}[5m]) / rate(llm_requests_total[5m])"}]
},
{
"title": "活跃请求数",
"type": "graph",
"targets": [{"expr": "llm_active_requests"}]
}
]
}
}
|
告警规则
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
|
groups:
- name: ai-service
rules:
- alert: HighLatency
expr: histogram_quantile(0.95, rate(llm_request_duration_seconds_bucket[5m])) > 5
for: 2m
annotations:
summary: "P95 响应时长过高"
- alert: HighErrorRate
expr: rate(llm_requests_total{status="error"}[5m]) / rate(llm_requests_total[5m]) > 0.05
for: 1m
annotations:
summary: "错误率过高"
- alert: HighCost
expr: sum(rate(llm_cost_total_yuan[1h])) > 100
for: 5m
annotations:
summary: "单小时成本过高,可能有滥用"
- alert: HighGPU
expr: nvidia_gpu_utilization > 90
for: 10m
annotations:
summary: "GPU 利用率过高"
|
日志(用 Loki)
1
2
3
4
5
6
7
8
9
10
11
12
|
import logging
import logloki
handler = logloki.LokiHandler(
url="http://loki:3100/loki/api/v1/push",
tags={"service": "ai-service"},
)
logger = logging.getLogger()
logger.addHandler(handler)
logger.setLevel(logging.INFO)
logger.info("user_query", extra={"user_id": "xxx", "query_length": 50})
|
任务 3:混沌演练 + SLO 报告
目标:验证系统"出问题能扛住 + 10 分钟内恢复"
难度:⭐⭐⭐
时间:1 天
4 类混沌演练
1
2
3
4
5
6
7
8
9
10
11
|
docker network disconnect ai-network ai-service
kubectl delete pod ai-service-xxx -n ai-system
python mock_llm_failure.py
docker stop postgres
|
每个演练记录以下内容:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
| ## 混沌演练记录 #1:网络中断
### 场景
模拟 ai-service 容器断网 30 秒
### 监控指标
- 错误率:5% → 23% → 恢复
- P95 响应时长:2s → 8s → 恢复
- 用户感知:部分用户看到 502 错误
### 恢复时间
- 检测到故障:45 秒
- 自动恢复:2 分钟(容器自愈)
- 完全恢复:3 分钟
### 改进措施
- [ ] 加健康检查减少检测时间
- [ ] 加前端友好提示"AI 暂时繁忙"
- [ ] 加自动重试 + 降级到缓存答案
|
SLO 报告
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
| # SLO 报告(2026-10 月)
## 1. SLO 定义
| 指标 | 目标 | 实际 | 状态 |
|---|---|---|---|
| 可用性(请求成功率) | ≥99.5% | 99.73% | ✅ |
| P95 响应时长 | ≤3s | 2.4s | ✅ |
| 单次成本 | ≤¥0.05 | ¥0.012 | ✅ |
| 月成本 | ≤¥50,000 | ¥36,500 | ✅ |
## 2. 错误预算(Error Budget)
- 月度可用性预算:0.5% × 月度请求数 = 18,000 次
- 已消耗:4,950 次
- 剩余预算:73%
- 状态:✅ 健康
## 3. 重大事件
| 时间 | 事件 | 影响 | MTTR |
|---|---|---|---|
| 10-15 14:30 | LLM API 限流 | 错误率升到 12%,持续 8 分钟 | 8 分钟 |
| 10-22 03:15 | Postgres 故障 | 服务降级 5 分钟 | 12 分钟 |
## 4. 改进措施
- [ ] LLM API 加多供应商 failover
- [ ] 加 Postgres 主从
- [ ] 完善 on-call 值班表
|
📚 系统学习:核心概念
概念 1:可观测性 3 大支柱
为什么重要:FDE 现场出问题,没可观测 = 摸黑调试。
| 支柱 | 回答的问题 | 工具 |
|---|
| Metrics | 系统整体怎么样? | Prometheus + Grafana |
| Logs | 出了什么事? | Loki / ELK |
| Trace | 1 个请求走过的路径? | Jaeger / Tempo / LangSmith |
概念 2:SLO / SLI / SLA 三者关系
- SLI(Service Level Indicator):指标(如可用性 99.5%)
- SLO(Service Level Objective):目标(如 ≥99.5%)
- SLA(Service Level Agreement):对外承诺(如未达成就赔钱)
FDE 实战建议:跟客户定 SLO,而不是直接定 SLA——SLA 一定有赔偿条款,要谨慎。
概念 3:混沌工程的 4 类实验
- 网络类:断网、延迟、丢包
- 计算类:CPU 飙高、内存溢出、进程 kill
- 存储类:数据库宕机、磁盘满
- 依赖类:第三方 API 限流、CDN 故障
FDE 实战建议:每季度至少做 1 次全套混沌演练,结果写进 SLO 报告。
⚡ 避坑指南:常见错误
| 错误类型 | 错误做法 | 正确做法 | 为什么 |
|---|
| 没监控上线 | "系统跑起来了" | Prometheus + Grafana + 告警 | 上线后出问题 = 摸黑 |
| 告警太多 | 每个指标都告警 | 只告警真正影响业务的 | 告警疲劳 = 真问题被忽略 |
| 没做混沌演练 | 假设系统稳定 | 每季度演练 1 次 | 不知道哪里会挂 |
| SLO 没写 | "稳定就行" | 量化指标 + 错误预算 | 没指标 = 无法评估 |
| 日志没结构化 | "出错了再查" | JSON 结构化 + 关键字段 | 没字段 = 没法筛选 |
🎯 模块 6 总结
你学到了什么
- ✅ LLM 调用链路追踪(LangSmith + 自定义 Metrics)
- ✅ Prometheus + Grafana 三件套 + 告警规则
- ✅ 混沌演练的 4 类实验
- ✅ SLO / SLI / SLA 三者关系
- ✅ 一份 SLO 报告怎么写
模块交付物 Checklist
下一步行动
- 进入 模块 8 · 业务指标与交付艺术(第 12 周)
- 定义北极星指标
- 写最后 1 份客户周报
- 沉淀 1 个可复用的 Playbook
➡️ 下模块预告
模块 8 · 业务指标与交付艺术(第 12 周,最后一周)
- 你将学到:业务指标定义、运营节奏、Playbook 沉淀
- 实战任务:1 份业务方周报 + 1 个 Playbook 文档
👉 继续阅读模块 8
📞 联系作者

加入 AI 编程交流群,第一时间获取 FDE 课程更新 + AI 落地实战案例。
💡 记住:上线 ≠ 交付,能稳定跑 + 出问题快速恢复 + 业务方看到价值,才算真的"上线"。
 微信进群


